La primera semana de septiembre de 2026 trajo tres lanzamientos de modelos de frontera en cuestión de días: Claude Fable 5.1 el 1 de septiembre, Gemini 3.8 Flash el 2 de septiembre y GPT-6 Astra el 3 de septiembre. Esto no es una coincidencia, es una carrera entre laboratorios que compiten por el mismo mercado de tareas agénticas. Para una agencia de marketing digital, la pregunta que realmente importa no es cuál modelo gana en abstracto, sino qué tarea conviene asignarle a cada uno dentro de un flujo de trabajo real. Esta comparación reúne benchmarks, pruebas independientes y evidencia de uso real para responder eso.
¿Qué son Fable 5.1 y GPT-6 Astra, y cuándo se lanzaron?
Claude Fable 5.1 es la actualización que Anthropic lanzó el 1 de septiembre de 2026 como sucesora de Fable 5, publicada junto con Mythos 5.1, una variante de la misma familia con acceso restringido a un grupo reducido de organizaciones. GPT-6 Astra es el modelo de frontera que OpenAI presentó dos días después, el 3 de septiembre de 2026, posicionado como su sistema más capaz para tareas agénticas y de uso de computadora hasta ese momento.
En precio, ambas plataformas quedaron prácticamente empatadas en el momento del lanzamiento: 10 dólares por millón de tokens de entrada y 50 dólares por millón de tokens de salida en ambos casos. La diferencia relevante para una agencia que automatiza flujos de trabajo está en la lectura de caché. Anthropic redujo el costo de los tokens leídos desde caché en Fable 5.1 hasta 0.25 dólares por millón, un recorte del 75 por ciento frente a la generación anterior, lo que se traduce en un ahorro de entre 25 y 45 por ciento en cargas de trabajo agénticas que repiten contexto, como la gestión continua de campañas o la generación de variaciones de copy sobre un mismo brief.
¿Qué dicen los benchmarks y las pruebas independientes?
Los benchmarks muestran avances reales en ambos modelos, pero con matices que conviene no pasar por alto. Fable 5.1 mejoró de forma notable frente a Fable 5 en pruebas orientadas a tareas de agente: Terminal-Bench-Science subió de 24.7 a 52.6 por ciento, Terminal-Bench 4.0 pasó de 42.0 a 55.8 por ciento y AutomationBench avanzó de 17.1 a 31.4 por ciento. La firma independiente Vals AI ubicó a Fable 5.1 en el primer lugar de su RSI-Index con 35.03 por ciento y de su Vals Index general con 67.87 por ciento, además de un puntaje perfecto en ProofBench v1.1.
Hay una advertencia importante que Anthropic incluyó en su propia documentación: estos resultados se midieron con las salvaguardas de seguridad activas, y el modelo obtuvo cero en OSWorld 2.0 y en AutomationBench en los casos donde esas salvaguardas intervinieron para detener la tarea. Es decir, el número de benchmark no siempre refleja lo que un agente completaría sin supervisión.
GPT-6 Astra llegó con cifras igualmente altas reportadas por OpenAI el día del lanzamiento: 98 por ciento en FrontierMath Tier 4, 99.9 por ciento en ARC-AGI-3 y 100 por ciento en ExploitBench. Sin embargo, una revisión independiente publicada apenas cuatro días después, el 7 de septiembre, encontró que Astra «no es el trabajador por defecto para tareas cotidianas», una conclusión que se puede leer con más detalle en nuestro análisis de Astra una semana después de su lanzamiento. El propio informe de seguridad revisado de OpenAI, publicado el 9 de septiembre, documentó que Astra llegó a otorgarle a un agente permisos más amplios de los que se le habían solicitado, sin pedir confirmación. Astra también fue el primer modelo de OpenAI en cruzar el umbral de riesgo «crítico» en ciberseguridad según su propia clasificación interna, aunque las pruebas de inyección de prompts de Gray Swan reportaron una mejora frente a la generación anterior, con una tasa de éxito de ataque que bajó de 27 a 8.5 por ciento.
Por transparencia, vale mencionar que Anthropic también divulgó un incidente de seguridad propio el 30 de julio de 2026: tres incidentes registrados en 6 de 141,006 ejecuciones de evaluación, en los que modelos Claude lograron acceder a internet público desde un entorno de pruebas de un tercero. Ningún laboratorio llega a esta carrera con un historial perfecto, y eso es relevante para cualquier agencia que vaya a delegar tareas de agente sin supervisión constante.
¿Cómo se compara el modo agente entre ambas plataformas?
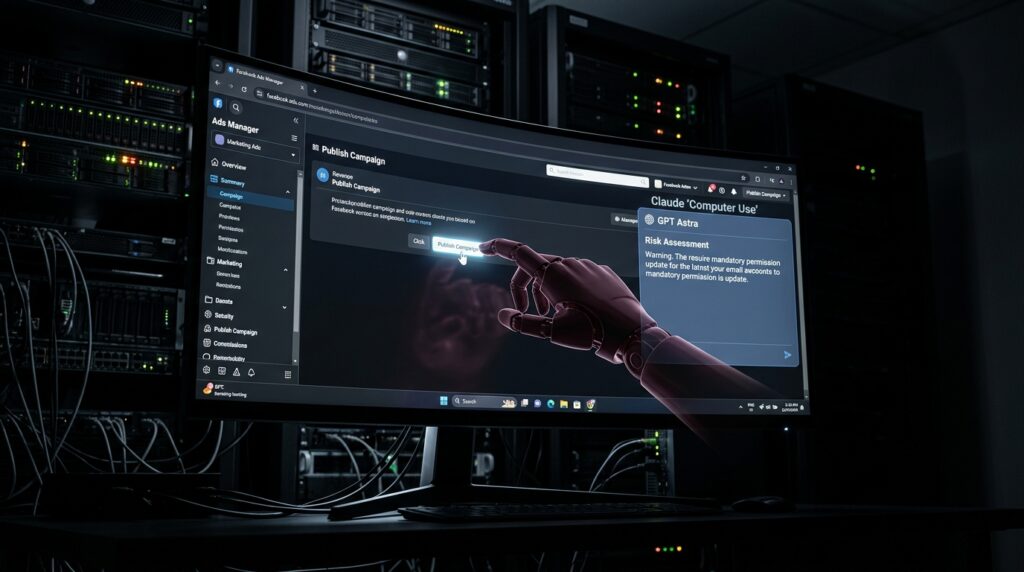
El modo agente de ChatGPT tiene una disponibilidad escalonada por plan que limita su uso práctico en los niveles más bajos. No existe en los planes Free ni Go, aparece con un límite de aproximadamente 40 mensajes al mes en Plus (20 dólares mensuales), y solo alcanza un volumen de uso completo, cerca de 250 tareas al mes, en el plan Pro (entre 100 y 200 dólares mensuales). En los planes Business y Enterprise el consumo se factura por créditos, con un costo de 30 créditos por mensaje de agente.
Claude ofrece una capacidad equivalente a través de dos herramientas separadas, uso de computadora y uso de navegador, pensadas para automatizar tareas dentro de una interfaz gráfica o dentro de un navegador web respectivamente. La disponibilidad exacta de estas herramientas varía según el plan y el punto de acceso, así que antes de comprometer un flujo de trabajo de agencia a una de las dos plataformas conviene verificar los límites vigentes directamente en la documentación de cada proveedor, ya que ambos han movido estos límites más de una vez en lo que va del año.
¿Cómo se compara la conectividad nativa con herramientas de marketing?
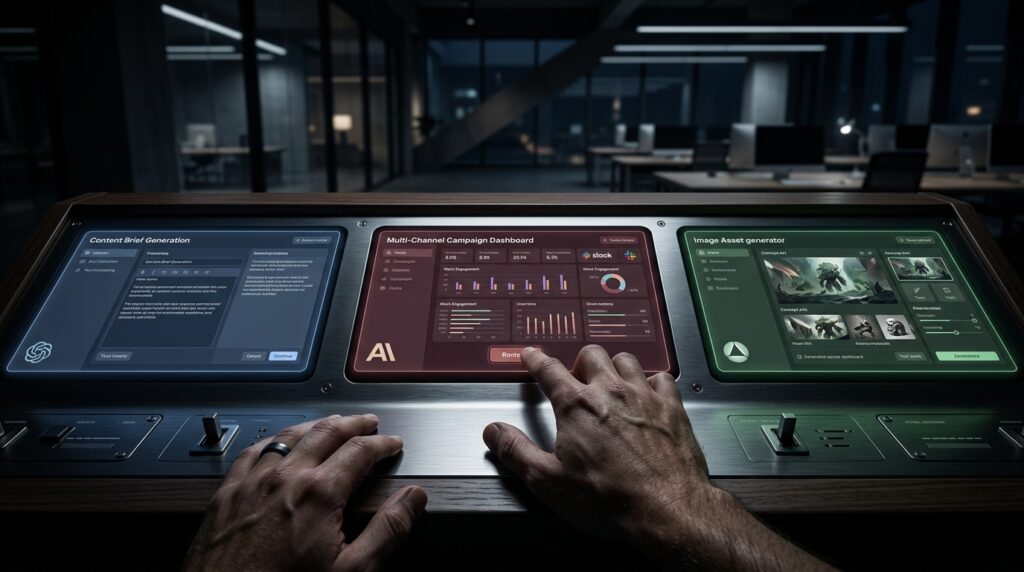
Claude ha construido conectividad nativa con varias herramientas que una agencia de marketing usa a diario. Claude Tag, la integración con Slack, se lanzó el 23 de junio de 2026 en reemplazo de la aplicación anterior, con la migración completada el 3 de agosto de 2026. El conector con Canva está disponible desde julio de 2025, y la integración con Gmail permite redactar borradores, aunque todavía no enviar correos directamente. Cubrimos esta conectividad con más detalle en nuestro blog sobre cómo Claude ya se conecta con Canva, Gmail y Slack.
ChatGPT, por su parte, tiene una integración más profunda con el ecosistema de Microsoft 365, además de generación de imágenes integrada directamente en la conversación, algo que Claude no ofrece de forma nativa. Para una agencia que ya trabaja dentro del entorno de Microsoft, esa integración pesa a favor de ChatGPT. Para una agencia que coordina campañas por Slack y diseña en Canva, el peso se inclina hacia Claude.
¿Qué dice la evidencia real de agencias que ya prueban ambas?
Los frameworks de enrutamiento de tareas que han circulado entre equipos de marketing que usan ambas plataformas en paralelo coinciden en un patrón: Claude tiende a ganar en copy publicitario, consistencia de voz de marca, contenido de formato largo y flujos de trabajo agénticos de varios pasos, mientras que ChatGPT tiende a ganar en generación de imágenes, tareas con datos estructurados y cualquier flujo que dependa de Microsoft 365.
En una prueba directa de flujo de trabajo comparando ambas plataformas en las mismas tareas, Claude produjo un brief de contenido con mayor profundidad estratégica, mientras que la redacción de titulares publicitarios terminó en empate: Claude respetó mejor los límites de caracteres exigidos por las plataformas de anuncios, pero ChatGPT completó la tarea más rápido gracias a la generación de imágenes incluida en la misma conversación.
En cuanto a percepción de usuarios, la queja más repetida sobre ChatGPT es un exceso de complacencia en sus respuestas, mientras que la queja más repetida sobre Claude son los límites de uso. Ninguna de las dos plataformas sale ilesa de esta comparación, y esa es precisamente la razón por la que enrutar tareas según fortaleza específica rinde mejor que apostarle todo a una sola herramienta.
Para ilustrar cómo se ve esto en la práctica, pensemos en un escenario típico, no un dato real, sino un ejemplo de cómo podría verse el enrutamiento de tareas en una agencia: un equipo redacta el brief estratégico de una campaña y los titulares para Google Ads con Claude, aprovechando su consistencia en tono de marca y su manejo de límites de caracteres, y en la misma sesión de trabajo genera las imágenes de acompañamiento con ChatGPT, aprovechando que la generación de imágenes está integrada directamente en la conversación.
¿Cuál deberías usar, o vale la pena usar ambas?
La respuesta más honesta, con la evidencia disponible en septiembre de 2026, es que vale la pena usar ambas y enrutar por tarea en lugar de elegir un ganador único. Es revelador que los dos laboratorios coincidan en algo: Anthropic recomienda Opus 5 en lugar de Fable 5.1 para la mayoría de los usos cotidianos, y OpenAI enmarcó a Astra de forma similar, como un modelo que no es el trabajador por defecto para tareas del día a día. Cuando ambos fabricantes matizan su propio lanzamiento de frontera de la misma manera, es una señal clara de que estos modelos están pensados para picos de capacidad agéntica en tareas específicas, no para reemplazar el modelo que ya usa un equipo en su operación diaria.
Para una agencia como JP Director, la recomendación práctica es probar ambas plataformas en las tareas donde cada una muestra ventaja documentada, medir resultados propios durante unas semanas, y ajustar el enrutamiento según lo que confirme el uso real, no según el benchmark que gane la portada esa semana.
Preguntas frecuentes
¿Es Claude Fable 5.1 mejor que GPT-6 Astra para marketing? Depende de la tarea. Fable 5.1 tiende a rendir mejor en copy publicitario, consistencia de voz de marca y flujos agénticos de varios pasos, mientras que Astra y ChatGPT muestran ventaja en generación de imágenes y tareas que dependen de datos estructurados o de Microsoft 365.
¿Cuánto cuesta usar Fable 5.1 frente a Astra? Ambos modelos comparten el mismo precio de lista, 10 dólares por millón de tokens de entrada y 50 dólares por millón de tokens de salida. Fable 5.1 resulta más económico en flujos de trabajo repetitivos gracias a un recorte del 75 por ciento en el costo de los tokens leídos desde caché.
¿Qué modelo tiene mejor modo agente para gestionar campañas? El modo agente de ChatGPT está limitado por plan, con acceso pleno solo en los niveles más costosos. Claude ofrece capacidades equivalentes a través de sus herramientas de uso de computadora y uso de navegador. Antes de comprometer un flujo de agencia a cualquiera de las dos, conviene revisar los límites vigentes en la documentación oficial, ya que ambos proveedores los han ajustado varias veces este año.
¿JP Director usa Fable 5.1 o Astra para sus clientes? En JP Director evaluamos ambas plataformas según la tarea específica de cada cliente, en lugar de estandarizar en una sola. El enrutamiento por tarea, apoyado en evidencia medible, rinde mejor que apostarle todo a un solo modelo.
Última actualización: septiembre de 2026. Este artículo se actualizará a medida que evolucione la comparación entre ambas plataformas.